适合交给专用模型的,通常是固定、重复、可评测的环节;复杂情况再交给规则、生成模型或人工处理。值不值得引入,取决于任务误差、人工复核成本和维护成本。“能本地运行”不等于 CPU 实时、中文可靠或可以直接商用。
资料范围与限制
这份清单来自单车酒吧搞机社第 76 集《Vibe知识大赏|别光追大模型,这12个专精小模型也许更有用》,页面显示发布时间为 2026-10-19,时长 7 分 45 秒。整理时读到视频标题、作者、章节和平台摘要,并回看了约 02:19 的“决策模型”画面及约 02:48 的 Kev、0.8B→4B 画面;没有完整核听,也没有逐字稿。下面的六类清单来自视频转述,再逐项核对官方仓库、模型卡、许可和关键许可讨论。
资料核对集中在 2026-10-21 至 2026-10-24。没有安装或下载模型权重,没有调用模型、跑基准,也没有更改任何现有检索索引。这里记录的是候选和采用边界,不是最新最优模型排名,也不构成本机性能结论。
原转述称这些模型大多支持本地部署、不少 CPU 可运行,并提醒商用前核对授权。本文保留为转述,不将其扩大成统一的硬件或许可承诺。
名称辨析:Kev 与 Jev
视频约 02:48 的画面写着 Kev、0.8B→4B。Kev 是独立的 Jev-like 决策模型项目,提供兼容 TypeSafe System One API 的接口及自行训练/运行的权重;本次核对的家族包括 0.8B、4B、9B 和 27B。它们支持加速器与 CPU 回退,官方也提供 Apple Silicon MLX 路线,但不能把所有尺寸笼统称为轻量 CPU 模型。Kev-0.8B 权重及底座标注 Apache-2.0;中文表现和实际规则判断仍需自测。原转述中的“K5”没有独立证据,不作为已确认型号或 Jev 的别名。
Jev 则是 TypeSafe 的 System One 模型:读取 state 与类型化问题,返回 Choice(选项)、Score(评分)或 Noul(是/否概率),由应用代码决定后续分支和动作。它不是完整的 agent runtime,也不负责文本生成、工具执行或任务编排。
在核对资料时,官方模型页给出托管 API;未找到可核验的公开权重或自托管安装路线,因此不能把 Jev 计为“已确认可本地 CPU 部署”。当时官方最新发布为 jev-1.14.0,但 jev-latest 仍指向 jev-1.13.0、jev-preview 指向 1.14;对照测试应固定版本。官方说明英语效果最好,中文需要实测,概率校准也不保证单次判断正确。官方列出的 1.13 已知问题包括算术、日期比较、多跳判断、对抗输入及选项顺序敏感;这些不能直接当成 1.14 的实测结论。
12 个候选
| 类别/对象 | 适用任务与边界 | 部署与许可要点 |
|---|---|---|
| 决策:Laya | 对输入和候选选项做分类、分级或二元判断并输出概率;多语言任务应选对应检查点。 | 官方支持 CPU/MPS/CUDA 等;多语言版约 322M、英文版约 421M。多语言权重标注 Apache-2.0。模型卡提示默认未校准、可能过度自信,部分零样本任务较弱。 |
| 决策:Kev | 基于 Qwen 底座加决策适配/读出,返回选项概率;提供兼容 Jev 的 TypeSafe System One API,但两者是独立项目。 | 本次核对的家族含 0.8B/4B/9B/27B,支持加速器与 CPU 回退,也有 Apple Silicon MLX 路线。Kev-0.8B 权重及底座标注 Apache-2.0;中文和领域判断须自测。 |
| 分类:SetFit | 少样本文本分类训练框架;需选择句向量底座、标签和训练数据,不是一个开箱即用的统一分类模型。 | 小底座、低吞吐任务可从 CPU 试起;中文应选择合适的多语言/中文底座。框架为 Apache-2.0,底座、数据及产出模型许可需分别核对。 |
| 抽取:GLiNER | 按给定标签抽取人名、地点、组织等实体,可作为抽取或脱敏候选;不保证理解复杂关系、否定或整份业务文档。 | 官方强调 CPU/消费级硬件,并支持量化与 ONNX;中文需选多语言版本验证。已核实的 gliner_multi-v2.1 标注 Apache-2.0;早期部分权重为 CC-BY-NC,不能只看代码仓库许可。 |
| 语言识别:OpenLID | 基于 fastText 的语言识别,覆盖 201 种语言;不是实体或字段抽取模型。 | 适合轻量 CPU 文本预处理;短文本、中英混写和领域词仍需验证。模型卡标注 GPL-3.0;这不等于禁止商用,但集成或分发时仍需核对适用义务。 |
| 向量:BGE-small | 将文本编码成检索向量;中文场景可明确评估 bge-small-zh-v1.5,不要只写含糊的 small。 |
可作为 CPU 检索候选;切块长度、索引规模和批量吞吐都要测。该权重标注 MIT。更换 embedding 通常需要重编码相应索引,不宜只为尝鲜就重建现有检索。 |
| 重排:Jina Reranker v2 | 对 query/候选文档对评分,用于召回后的排序;不能替代 embedding 向量模型。 | 官方提供 CPU 路径;逐候选计算,延迟随候选数和文本长度上升。多语言 v2 权重标注 CC-BY-NC-4.0,商业使用需另有授权或采用相应商业服务。 |
| 转写:SenseVoiceSmall | 语音识别及语种/情绪/事件标签。已发布 Small 的明确语种为普通话、粤语、英语、日语和韩语;多人说话人分离需要另配模型或流水线。 | 有 ONNX 等本地路线;桌面 CPU 转写不能证明嵌入式端低延迟或低功耗。源码 MIT;官方权重卡指向 FunASR 自定义模型许可,商业解释仍有待确认,见下文。 |
| 合成:F5-TTS | 文本转语音/参考声音条件合成,与转写方向相反。 | 可本地推理,但 CPU/MPS/GPU 的吞吐和实时率需实测。代码 MIT,官方预训练权重 CC-BY-NC-4.0;不能因代码许可宽松就默认权重可用于商业语音链路。 |
| 超分:Real-ESRGAN | 图像放大与修复,可用于素材处理;生成的细节不能当成原图事实。 | 适合离线批处理;ncnn/Vulkan 路线依赖相应图形能力,不等于纯 CPU 加速。仓库 BSD-3-Clause;权重、附带组件和输入素材权利需分别核对。 |
| 修补:LaMa | 按掩膜补全图像区域,区别于语言模型 LLaMA。 | 官方有 CPU 推理示例,但大图速度和内存仍需测。仓库 Apache-2.0;权重与素材也需分别核对,生成区域不应被当作实物证据。 |
| 预测:Chronos-Bolt | 从历史时间序列预测未来值/分位数;不是通用因果推断或自动调度器。 | 官方支持 CPU/GPU;Tiny 9M、Mini 21M、Small 48M、Base 205M。该权重标注 Apache-2.0。应按时间回测并与季节性朴素预测等基线比较;后续已有 Chronos-2,但这不自动替换本清单的研究对象。 |
SenseVoice 的许可边界
官方权重卡指向 FunASR Model License:§2 授予使用、修改、分享等权利并要求署名/保留模型名,§3 则包含“仅作为参考和学习使用”的措辞。
README 链接了一条允许商用/私有微调的成员回复,但该回复顶部已有 2026-09-22 状态更新,说明早期回复不是许可方最终确认。重新打开说明也称仍在等待许可方/核心维护者确认;本次核对时 issue #334仍为 open。
因此,较准确的记录是:商业许可解释待确认,不标作“已禁止商用”,也不标作“已完全澄清”。 正式商业集成前,应结合所选权重版本、协议和许可方最终确认;第三方 GGUF/ONNX 转换物也要另行核对。
Jev:适合筛选,不替人做决定
2026-10-24 阅读的公众号文章认为,Jev 更适合把大量输入做成筛选、分类、排序和检查结果,而非替人承担“要不要写、要不要发”这类需要背景、经验和责任的最终决定。文章提出的工作流是:生成模型起草候选,Jev 过滤或检查,人决定是否采用。
文章及其引用的社区案例报告了多种速度和成本数字,例如语音浏览器约 300ms、单次约 0.0002 美元;724 条广告约 40 秒、约 0.09 美元;3,282 条历史帖子约 8 分 34 秒、约 0.13 美元。另有航班搜索约 7.1 秒、Uber 演示约 21 秒但停在付款选择页。这些是作者/社区报告,不是独立复现或统一基准:模型版本、并发、重试、网络和计费边界并不齐全,不能外推为通用性能承诺。
接入形式也要以官方资料为准:官方介绍说明 Jev 直接返回类型化结果,而不是生成文本;快速入门使用 typesafe-sdk/TypeSafeClient 的 system_one 调用,以 state 加 Choice、Score 或 Noul 提问。原文章中出现的 OpenAI(base_url=...) + chat.completions + 自定义 JSON 输出,与本次读取的官方接入方式不一致,不能直接当作官方可运行示例。本次没有运行这些代码或调用 API。
原文章小标题称“12 个案例”,正文实际编号到 10;聊天案例还同时出现“约 1 秒”和“70 毫秒”两种判断耗时,测量口径不清。Uber 演示没有完成叫车,仿真也不能代表真实控制;快速判断更不能代替原始来源核验或证明事实正确。
怎样开始评估
- 资料结构化:先测抽取,再决定是否加分类。 用有代表性的样本副本提取日期、型号、组织和待确认事项,保留原文位置;复杂否定、责任和历史修正交由人或更强的模型复核。固定格式和编号优先考虑规则;只有分类量和标签样本确实存在时,再评估 SetFit。留出测试集,按字段报告精确率和召回率。
- 离线语音转写:先量化人工修订负担。 多人分离、标点和领域词汇可能还需额外处理。开放环境还要单独验证拾音、风噪和回声;桌面 CPU 转写不能证明嵌入式设备可实时、低功耗运行。F5-TTS 默认权重不应在商业许可未收敛前直接纳入商业语音链路。
- 检索:先评估现有结果,再决定是否换模型。 若中文召回确有不足,用小规模副本和固定问答集比较 BGE-small-zh;重排则单独衡量排序增益与额外延迟。更换 embedding 前应确认重编码成本;Jina v2 的商业授权也需先解决。
- 图像工具按需使用,预测放后。 Real-ESRGAN/LaMa 可用于有权处理的资料图片或演示素材,不必常驻服务。等积累足够时间序列后,再将 Chronos-Bolt 与简单预测基线比较;预训练模型不能补出不存在的运营数据。
若把决策模型用于工单或任务路由,应先与规则/标签基线比较,保留低把握和异常输入的人工复核;在真实领域数据上验证、校准后,再讨论概率阈值。把一个大问题拆成单一、可评估的 Choice/Score/Noul 判断,规则负责确定性判断,复杂任务交给生成模型或人工处理。
支付、权限变更、发布以及其他不可逆或安全关键动作,模型只能提供候选或风险信号,不能替代确定性授权和人的最终确认。模型组件可以串接在脚本或工具流程中;能组合不代表必须部署一个总控平台,现有工具接口足够时直接复用即可。
SenseVoice 架构示意
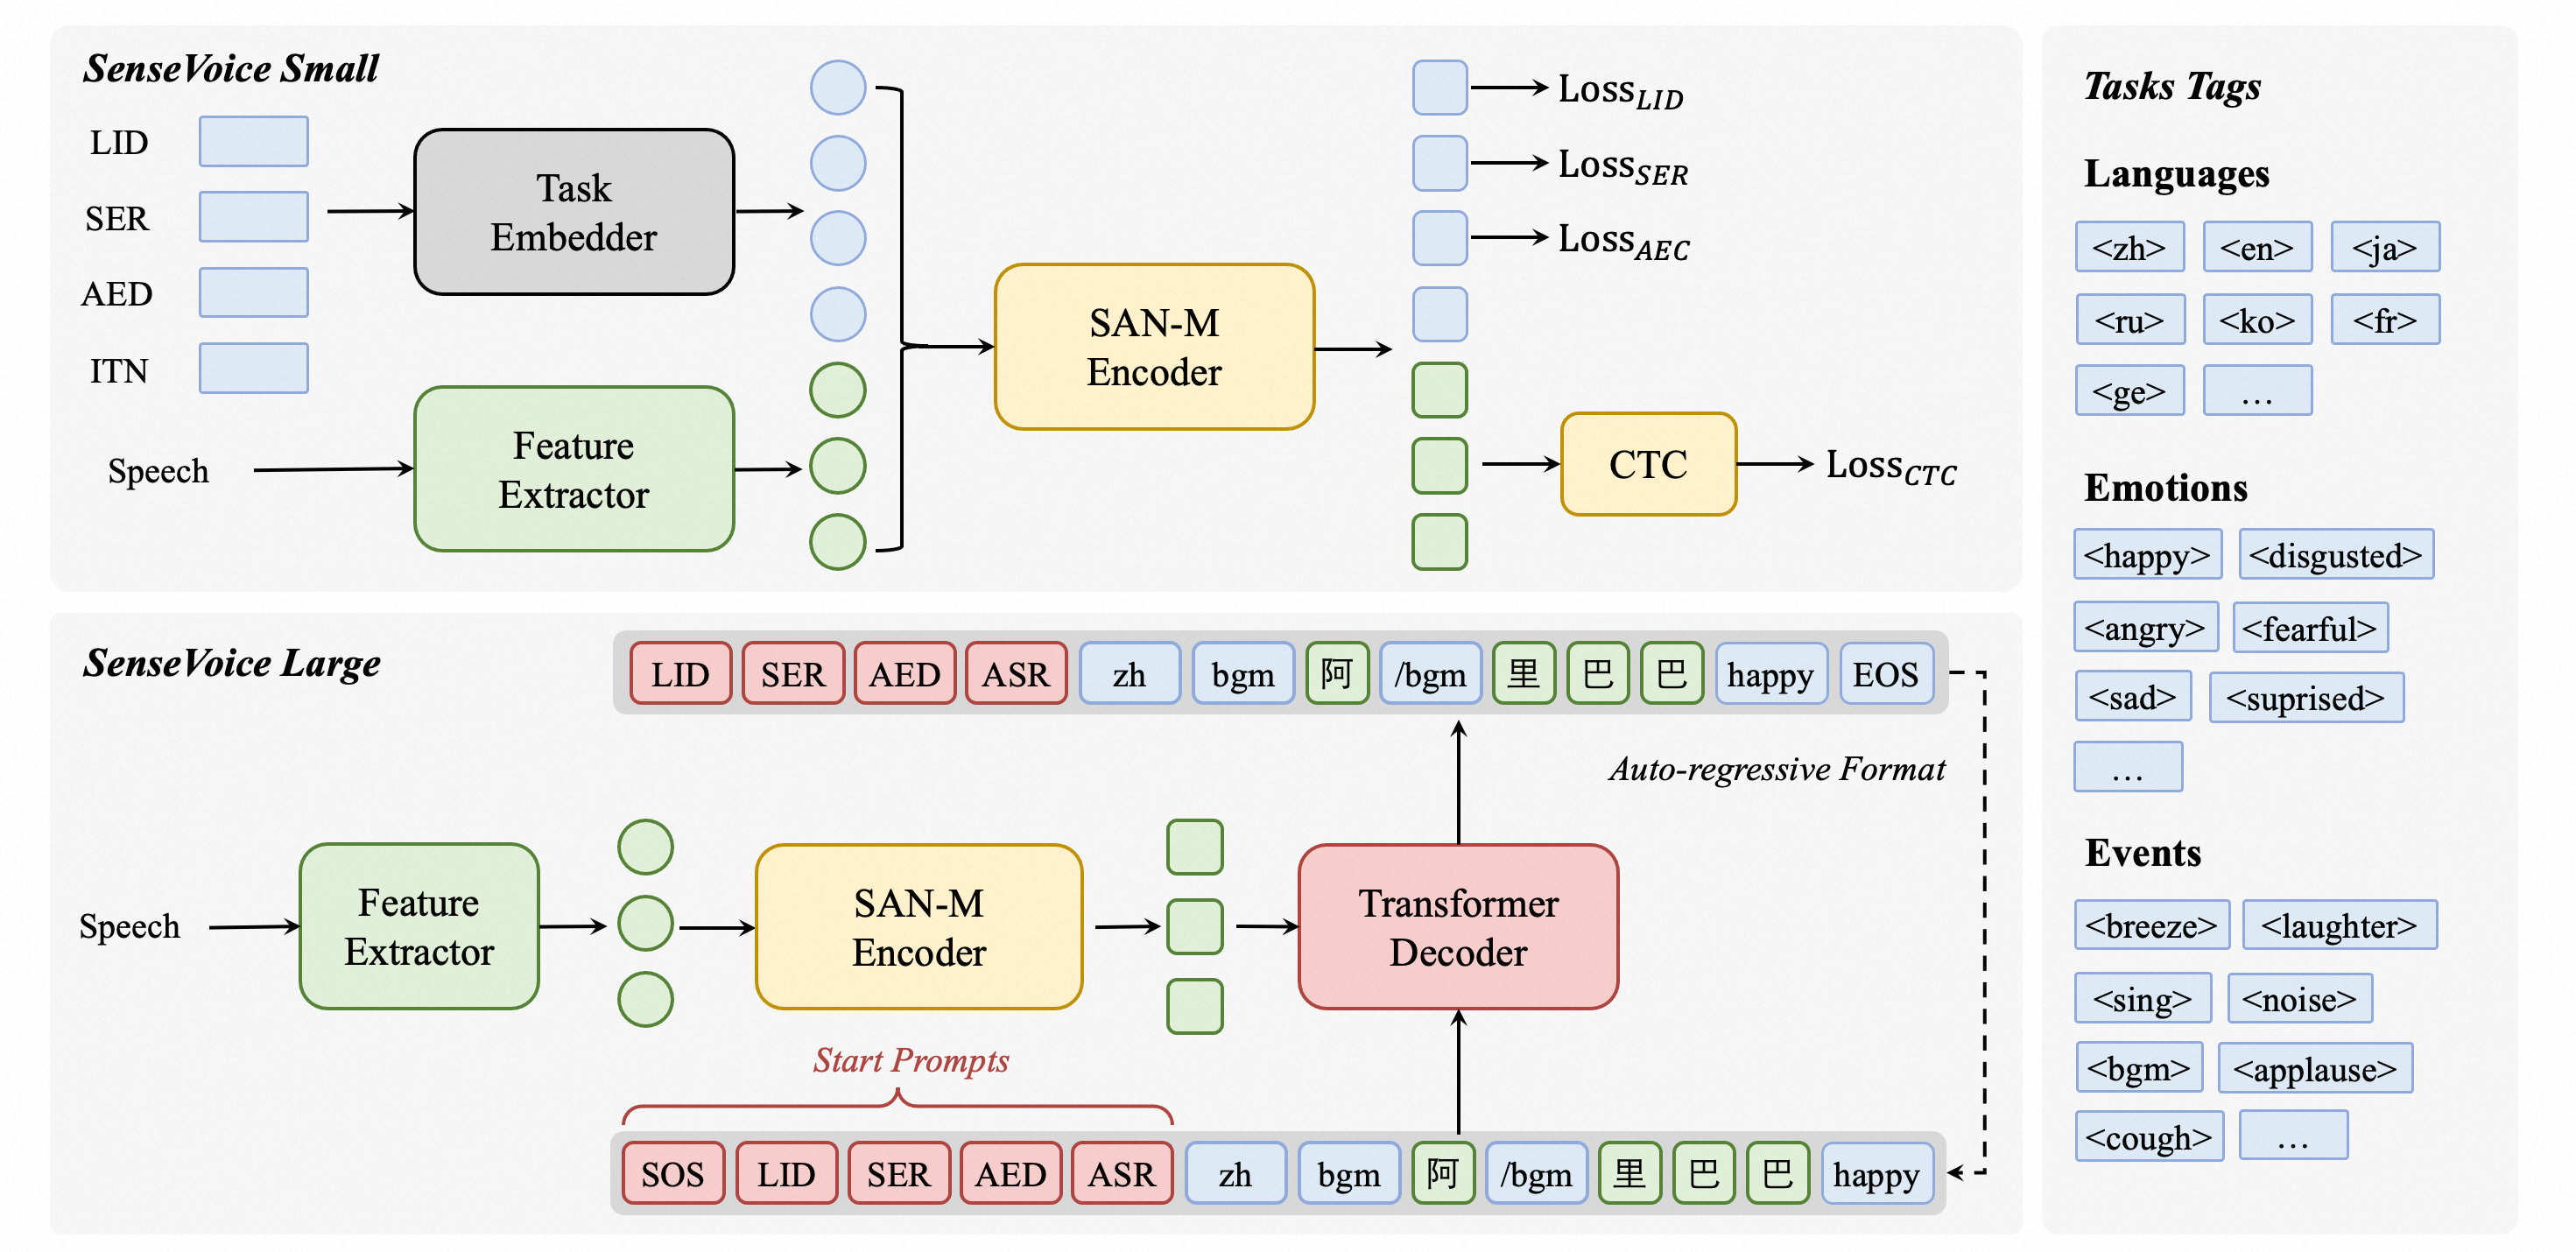
图片来源:FunAudioLLM/SenseVoice。该图用于说明专用语音组件,不代表整份模型清单。

评论