分类归档: AI

Craft Anything 能做什么?从逆向分析到软件重建

Craft Anything 是 ArtCraft 的开源软件研究与重建工作台。它能检查网站、应用、游戏和文件,把分析结果整理成可复核的证据,再交给编码 Agent 构建新项目、对比结果并迭代。桌面应用、CLI 和 MCP 共用一个 Rust 引擎。

这个项目最值得关注的是它如何把研究、构建和验证串起来。当前仍处于早期 Alpha 阶段,适合从网页、小工具或单项功能入手。复杂应用、供应商 SDK 和硬件行为需要逐项验证。本文基于 2026 年 11 月 3 日核对的官方文档、发布记录与部分源码。
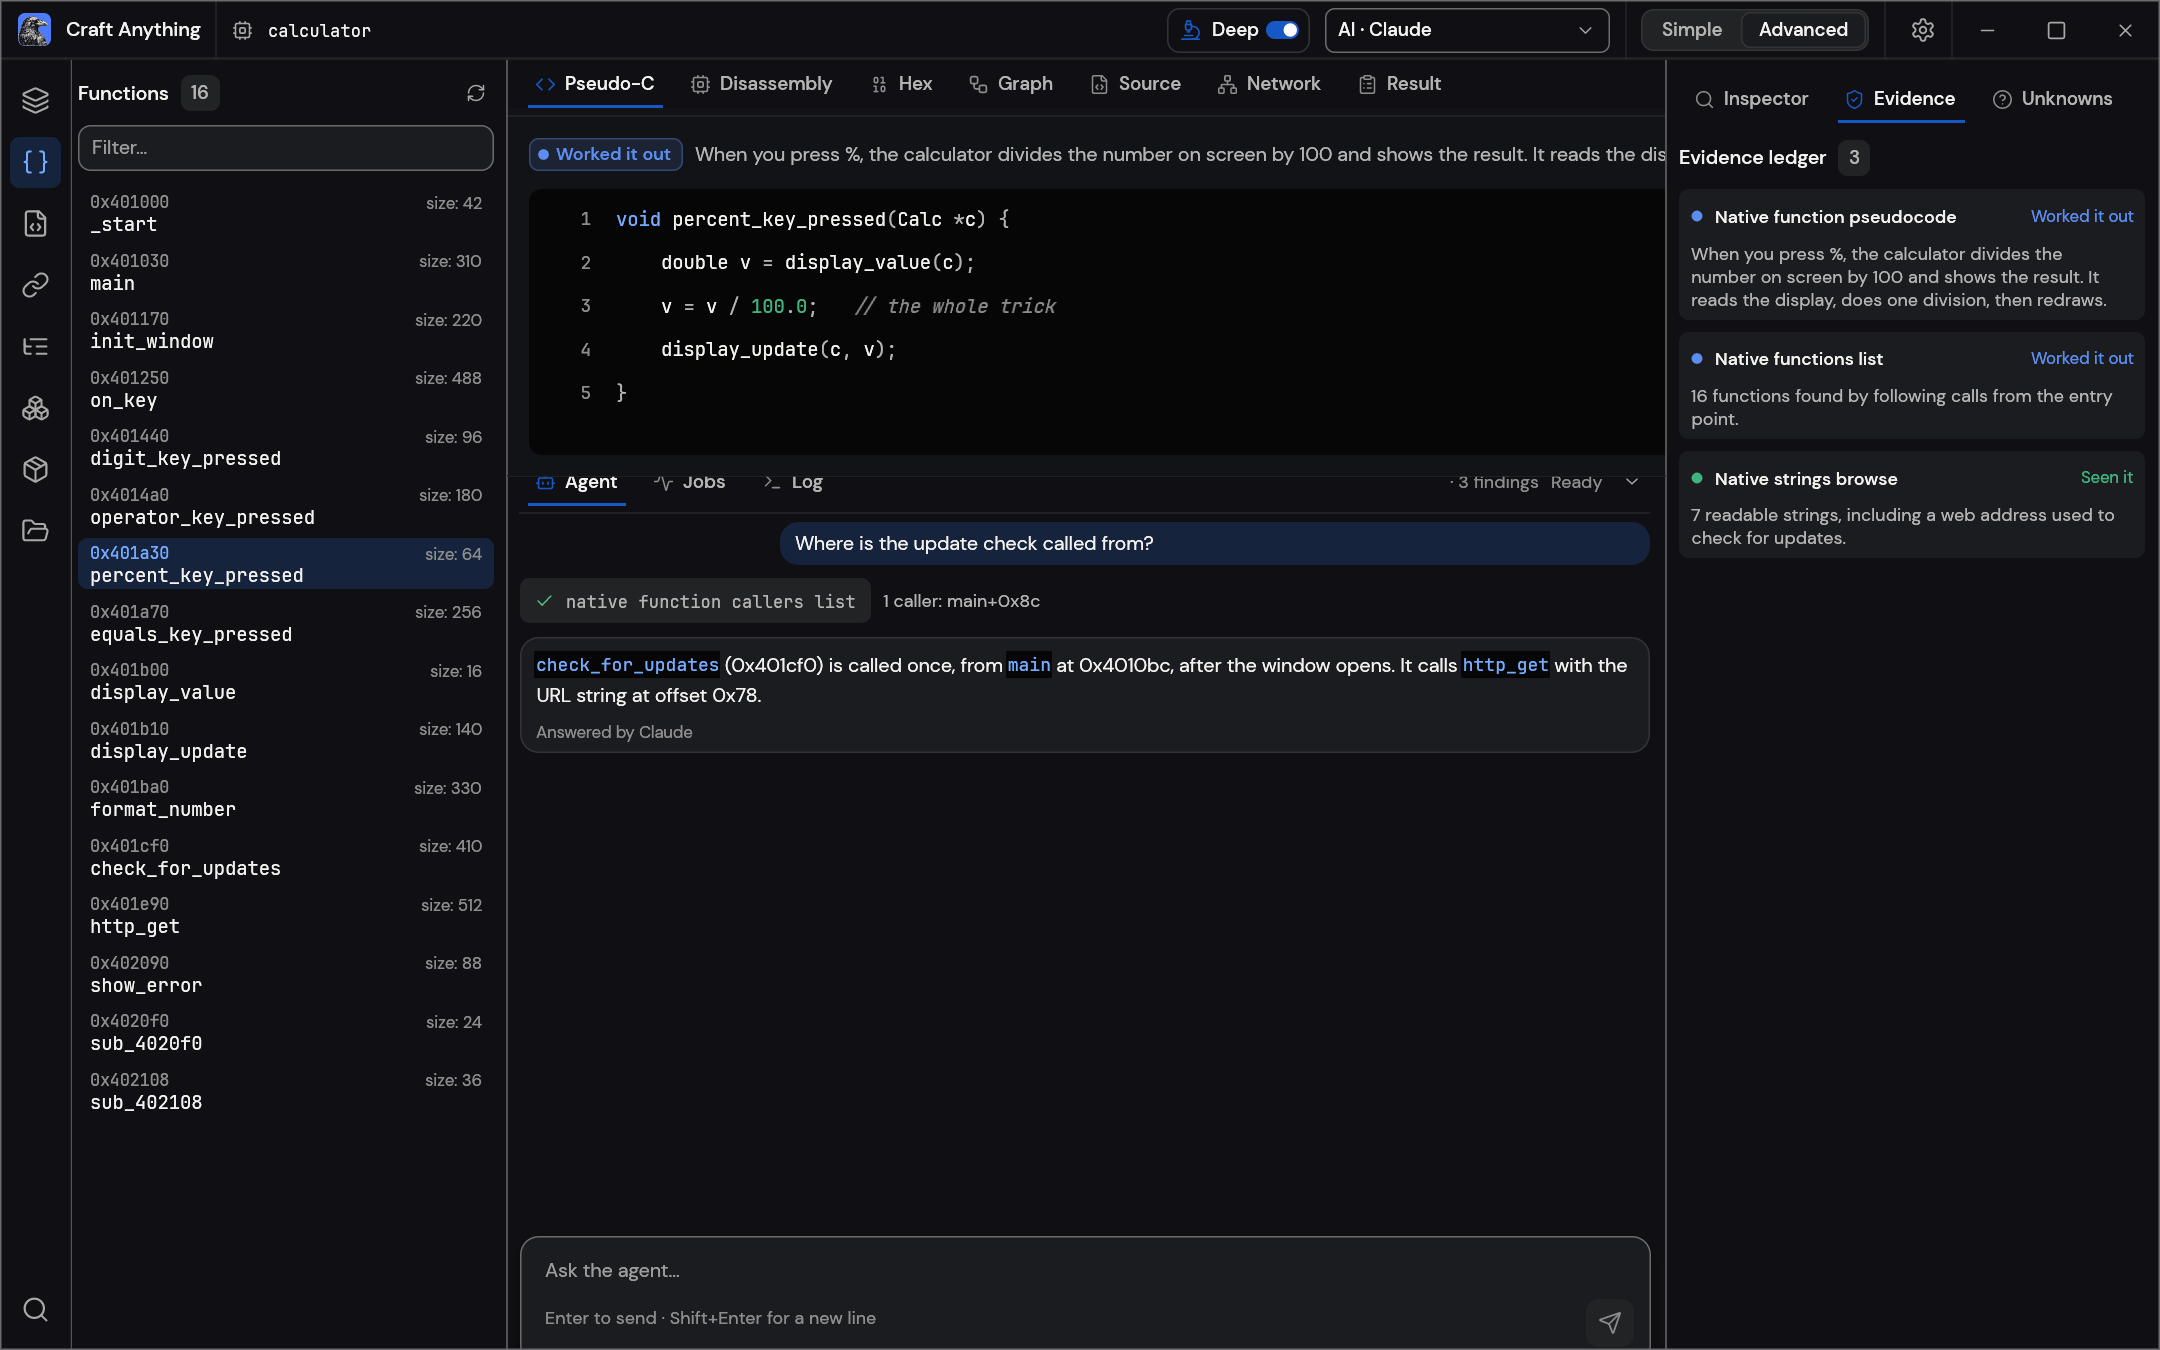
Craft Anything 官方工作台,左侧是函数列表,中间是伪 C 和 Agent 对话,右侧是证据台账

官方工作台示例。图片来源

公开版本与使用条件

核查当天,最新公开版是 v0.3.0,北京时间 11 月 3 日 01:58 发布。发布页列出 29 个附件,包括 macOS Universal DMG 和 CLI ZIP。本文查阅的主分支提交是 09849084dfb22b4d1ae5d4abbc7411d18942f77b,其版本字段已标为 0.4.0。下文涉及主分支实现的细节,试用时需要回到实际安装的版本核对。 发布页 · Cargo.toml

  • 许可证和入口。 根 manifest 与许可证文件采用 MIT OR Apache-2.0 双许可,GitHub API 的单个许可证字段显示 Apache-2.0。项目提供 egui 桌面应用、CLI 和 MCP,WebAssembly 浏览器查看器覆盖部分能力。核查时的主分支要求 Rust 1.97+。
  • 编码 Agent。 Claude Code 接入最完整,使用本机已登录的 CLI。Codex 已有适配器,官方仍将真实安装环境下的验证列为待办,会话恢复等能力也有缺口。
  • 模型与外部工具。 支持配置 Anthropic、OpenAI、OpenRouter 和本地 OpenAI 兼容服务。官方仍将 API Key 构建列为待实测,本地模型构建也有后续工作。增强分析和运行观察按需使用 Ghidra、Chromium、Frida、adb 或游戏引擎。模型额度另计,图片与 3D 生成需要启用对应功能并提供 fal.ai 密钥。 官方 README · 路线图

核查时,README 仍写着首次公开发布待完成。发布记录和路线图均已记载 v0.3.0。

已有能力与验证范围

网站研究与重建

工作台可以采集截图、提取可见文字、测量布局并研究多个页面。生成项目后,可以在桌面、平板和手机宽度下比对。官方记录中的一个网页样本用时 1.5 分钟,达到 96% likeness。这个指标衡量该样本的布局与感知相似度,功能覆盖需要另行验证。 官方验证记录

静态分析与证据管理

原生二进制分析包括函数、字符串、交叉引用、伪 C、调用图和值流。工具也覆盖 .NET、Java/Android、Apple、Electron/JavaScript、固件、抓包文件、数据库和游戏资源。JS/Electron 已有应用关系图、版本比较、调用和事件追踪。原生值流限于寄存器,内存和栈槽超出范围。静态调用图覆盖可以解析的调用。

官方列出 298 个引擎工具,计入 AI 和设置层后共有 314 个。逐工具验证表中,adb 仍有 23 项等待真机验证。分析结果可以随调查项目保存和分页查看,证据里会标注置信度、覆盖范围、限制及未知项。 逐工具验证表 · 原生分析源码

应用与游戏重建

编码 Agent 可以按指定语言、框架或引擎生成项目,再运行构建检查。官方记录中的小型桌面应用案例用时 9 分钟,验收条件是编译成功。游戏自测仍依赖生成程序自行上报,独立观察玩法和测量关键数值还待实现。判断行为是否复现,需要观察实际运行和输入输出。 官方验证记录

社交媒体说法核对

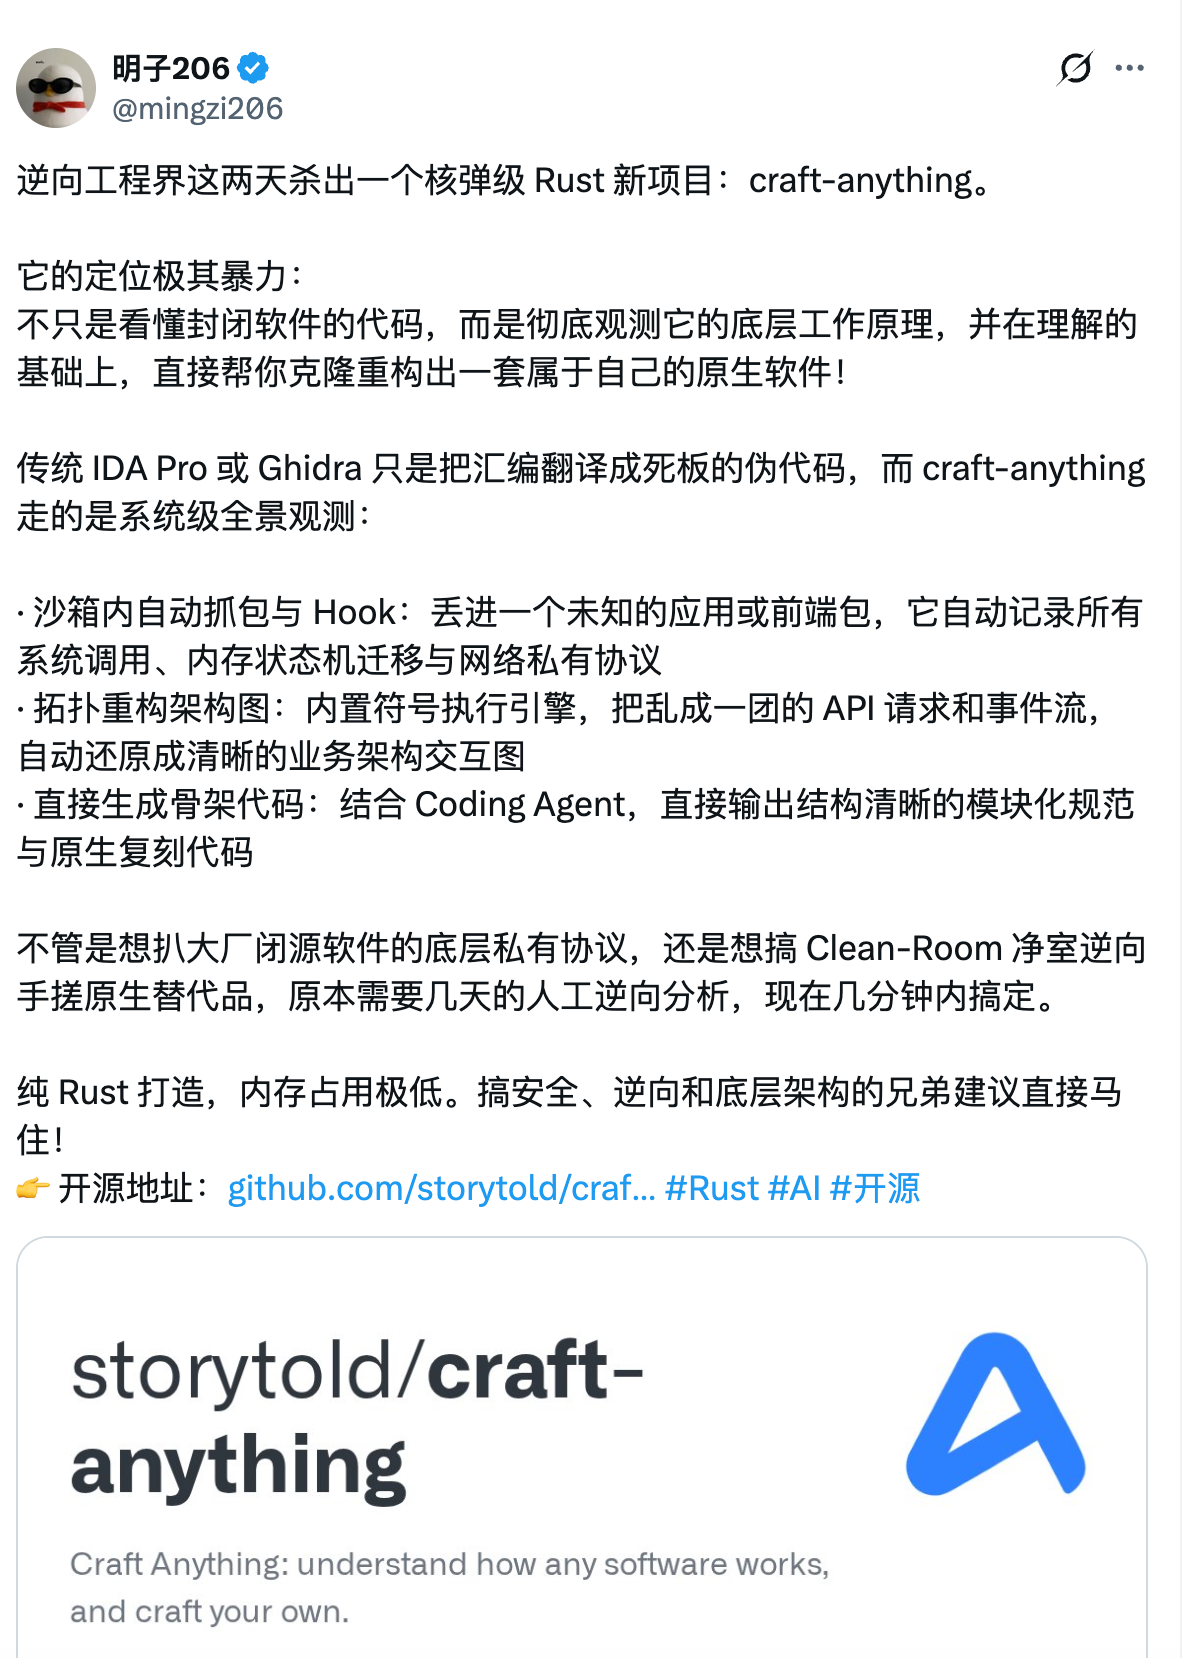
最初的线索来自 X 上明子206(@mingzi206)的一则帖子截图。下面按官方文档和源码核对其中几项说法。查看帖子截图

  • 自动捕获全部运行行为。 已有浏览器观察、进程捕获、抓包解析和 Frida 脚本接口。应用和游戏的自动研究主要依赖静态分析,启用运行研究后可以启动目标一次,取得窗口截图和 UI 树。Frida 的 frida_session_begin 先保存 attach 或 spawn 意图,执行脚本时才调用外部 CLI 做限时操作。持续跟踪系统调用、内存变化或私有协议,需要额外验证。 Frida 工具源码
  • 自动还原完整业务架构。 静态图、反汇编、伪 C 和寄存器值流能提供线索。动态分派、内存状态和服务端逻辑仍可能缺失,通用符号执行与业务语义恢复也缺乏相应证据。 原生分析源码
  • 几分钟重建原生软件。 目前公开案例的验收分别是网页相似度和小应用编译。要判断复杂应用能否在几分钟内实现行为等价,还需要按实际功能测试。 官方验证记录
  • 极低内存占用,取代 IDA 或 Ghidra。 核心用 Rust 实现,完整流程还可能调用浏览器、游戏引擎、Ghidra 和模型。所查材料缺少全流程内存基准或反编译能力的横向实测。项目的差异主要在于将分析证据、Agent 和重建流程整合在一起。 官方 README

净室模式与试用范围

默认的 Clean room 模式依据截图、可见网页、布局测量和获准观察的窗口等外部表现。Deep 模式开放文件、脚本、反编译等内部分析。模式名称只描述工具的工作方式。审批能否约束读取和命令执行,取决于具体 Agent 适配器。路线图仍列有 Auto mode 的删除判断问题,进程捕获的隔离也取决于宿主能力。 路线图 · 进程捕获源码

和 REA 相比,REA 更侧重为已有 Agent 提供逆向工程工具和证据,Craft Anything 则把研究、构建和多轮比对放进一个带桌面界面的项目。两者能力有重叠,本文没有做性能或准确率对照。

我会先把 Craft Anything 列为观察项目。有明确目标时,网页或 Electron 的单项功能适合作为小样本,因为容易限定输入、输出和验收范围。试验可以用自有或获授权的样本,在独立、无敏感凭据的环境中接入 Claude Code,关闭自动批准,并对照正常和异常输入的实际运行结果。Android APK 或 SDK 可以用于授权排障,涉及硬件的判断仍需供应商协议、真实板卡与现场验证。

核查于 2026 年 11 月 3 日,范围包括 GitHub 元数据、发行记录、固定提交的文档与部分源码。本文未安装程序、运行目标样本或配置 MCP 与编码 Agent。
TencentDB Agent Memory 与 Hy Memory 对比

在同一台电脑上跨 Codex、WorkBuddy、Hermes 和 OpenCode 复用历史,优先看 Hy Memory/MemHub。个人要在 Mac 和 Windows 间共享记忆,则值得优先验证 TencentDB Agent Memory。多人共用项目 Wiki、代码索引、可复用 Skill,或把独立 CodeBuddy 纳入统一记忆入口,TencentDB Agent Memory 更贴合。 这是根据源码、文档与发行记录作出的场景判断。两套系统均未在本机部署,也没有用同一组会话做对照测试。

腾讯云版如何工作

  • 入口是模型代理。 Agent 把模型请求指向 Memory Proxy。代理按用户凭据识别身份并解析 Team → Agent → Task 绑定,在适用的请求上注入已授权记忆,再调用配置的上游模型。启用归档后,会话进入 Memory Core。历史会话也可以单独导入,例如 Codex 的导入工具可按目录选取本地 session。 Codex 代理源码 · Codex 历史导入
  • 对话按四层组织。 L0 保留原始对话,L1 提炼事实、偏好和约束,L2 按场景组织知识,L3 形成长期画像。L2/L3 用于快速恢复上下文,精确查询可沿关键词和向量召回查回 L1/L0,以 RRF 合并排序。 架构说明 · 召回实现
  • 知识和经验可以单独分发。 Chat Memory、Skill、LLM-Wiki、CodeGraph 都作为资产管理。Skill 沉淀可重复执行的做法,Wiki 从文档构建可查询的页面,CodeGraph 从仓库索引文件、符号和调用关系。Wiki 和 CodeGraph 异步构建,Agent 可用 /v3/tools/list 和 /v3/tools/call 按需查询。v2.0.3 已含富文档导入,变更日志也记录了私有仓 SSH 建图,实际凭据和构建链路仍需验收。 Knowledge OpenAPI · 变更日志
  • 资产权限和 Agent 绑定分别判定。 源码对 private 只允许 owner 访问,对 restricted 的普通成员要求匹配 ACL,团队管理员仍可凭角色获得部分操作权限。固定绑定另有规则,当前 canBindAsset 拒绝绑定 restricted 和 task 资产。试用时应分别验证面板读取、工具调用与代理注入。 权限判定源码
  • 可自托管。 Docker 入口启动 Core、Hub(Panel + Knowledge)和 Proxy。默认 SQLite 持久化,MongoDB 是可选实验后端。安装分别配置记忆处理模型和对话上游,两组可复用。通过代理的模型请求会流向所配上游,其中可能包含注入的记忆。 安装指南 · 容器部署

与 Hy Memory/MemHub 对比

维度 TencentDB Agent Memory Hy Memory/MemHub
产品定位 团队服务,给不同成员、Agent 和任务分配可共享的资产 Hy Memory 是 Python 记忆引擎,MemHub 是本地优先的桌面/CLI 产品,汇总获授权的历史并提供跨工具召回
采集与召回 代理采集新流量并按绑定注入。历史会话有独立导入入口 主要靠已授权的日志扫描、Hook/插件采集。通过 MCP/Skill 主动查询,部分宿主支持自动召回
记忆结构 L0–L3 对话记忆,另有 Skill、LLM-Wiki、CodeGraph Chat 的分层长期记忆、Working 的事实与经验、Coding 的经验和代码版本演化链
代码与文档 CodeGraph 回答仓库里符号在哪里、有哪些调用、修改影响哪里。Wiki 支持团队分发 Coding diff 链回答某次任务中的代码怎样演进、有哪些可复用经验。两者的图和链服务于不同查询
权限与部署 用户 Key、团队角色、资产可见性、ACL 与固定绑定。代理进入模型请求链路 来源采集、模型处理和宿主 Recall 分开授权。现有宿主仍可用原模型通道,选用外部记忆模型时会发送相关的授权内容。主分支另有 CLI/API 多用户能力,发行状态见下
开源许可 MIT Apache-2.0

腾讯云版架构 · Hy Memory SDK 架构 · MemHub 授权与宿主支持 · MemHub 隐私说明

五个常见 Agent 的接入方式

Agent 腾讯云版接入 MemHub v1.0.5
Codex 自定义 Responses provider。首次交互绑定文档要求 Plan 模式,v2.0.3 增加用户级默认绑定。桌面端实际会话、流式工具和会话恢复待测。 接入说明 扫描/Capture Hooks 写入,MCP + Skill 主动召回,无自动 Prefetch。 接入说明
独立 CodeBuddy 有 ~/.codebuddy/models.json 接法。文档注明 4.10.2–4.10.4 缺少 sessionId,无法完成初始化。独立 CLI/IDE 各自待测。 接入说明 支持矩阵仍未列独立 CodeBuddy。WorkBuddy 的插件格式名和目录覆盖变量不能证明独立版已接通。 支持矩阵
WorkBuddy Desktop 用 Responses,Web 用 Chat Completions。 接入说明 插件 Hook 可自动注入,另有 MCP + Skill 主动查询。 接入说明
Hermes 自定义上游走 Proxy,用请求头预选 Team/Agent/Task。 接入说明 v1.0.5 已提供原生只读 MemoryProvider 自动 Prefetch,并占用唯一的 memory.provider 槽位。会话写入仍由扫描负责。 接入说明
OpenCode v2.0.2 起有官方 provider 配置,记忆链路依赖适配器的路由标记。 接入说明 MCP 主动查询,DB 扫描/JS Capture Plugin 写入,无自动 Prefetch。 接入说明

个人跨机器共享同一份记忆

以一台 Mac 和一台 Windows 交替或并行工作为例。MemHub v1.0.5 有 macOS arm64 版本,Windows 无官方制品。若试 TencentDB,两端各开独立会话,在服务端绑定同一份项目记忆。并行试验用两个不同事实,再分别开新会话验证双向召回及落库时间。记忆的后台提炼有延迟,进行中的同一聊天、工作区文件和未提交改动需要各自的同步方式。 MemHub 平台支持 · Codex 会话标识

  • 常在线、自动采集和召回。 两者中优先验证 TencentDB。把一套服务放在常在线主机上,各设备通过 Tailscale 将受支持 Agent 的模型入口指向同一 Proxy,并使用同一个个人账号和同一个 Agent 绑定。这样,通过代理的会话可以汇入同一库,各设备也可以从同一库召回。未经过 Proxy 的历史需另行导入。主机或网络中断时,走这个入口的模型请求也受影响。 局域网/多机部署说明
  • 保留各机器原有模型通道或需要离线。 MemHub v1.0.5 的产品接入围绕本机 Runtime、loopback Broker 和单写锁设计。未核实多台 MemHub 自动双向合并记忆的产品能力。Hermes 可通过自行管理的 Hy Memory HTTP 服务做远程召回,但需要鉴权网关,且仅覆盖该接法。Nextcloud 可同步普通 Markdown 交接笔记,运行中的 MemHub 数据目录不适合作为多机共享目录。 MemHub Runtime 架构 · Hermes 远程直连接入边界

核验依据与适用场景

  • 版本。 腾讯云版公开最新 Release 为 v2.0.3(10 月 26 日),源码核验 2002196。MemHub 公开最新 Release 为 v1.0.5(10 月 28 日,绑定 SDK 2.0.8),有 macOS arm64 App/Runtime 和 Linux x64/arm64 Runtime。Hy Memory 主分支 2f9e028 已写 MemHub v1.0.6/SDK 2.0.14,但截至 11 月 5 日查询 GitHub Releases API 返回 404,远端也未见 v1.0.6 tag,因此按主分支能力记录。 腾讯云版 Release · MemHub 公开 Release · MemHub 主分支版本说明
  • 效果证据。 腾讯云版 README 自报 PersonaMem 从 48% 到 76%(+28 个百分点)。Hy Memory 提供 Chat 长期记忆和 CMB 编码记忆研究。现有资料不足以做同模型、同题集、同成本的横评,也没有本机延迟、记忆准确率或权限隔离实测。 腾讯云版 Benchmark · Hy Memory 论文与基准
  • 团队试点。 如果需要跨人共享项目上下文,可用一个脱敏仓库、一份文档、两个普通账号,先验证独立 CodeBuddy → 腾讯云 Proxy → 新 Codex 会话的跨工具接力,再检查未授权账号能否从面板、工具或注入结果读取同一资产,同时观察流式工具调用和 Proxy 异常时的行为。个人试用可先接 Codex 与 WorkBuddy,用少量历史检查召回、原文追溯和撤权。 MemHub 宿主接入说明

专精小模型清单与应用建议

适合交给专用模型的,通常是固定、重复、可评测的环节;复杂情况再交给规则、生成模型或人工处理。值不值得引入,取决于任务误差、人工复核成本和维护成本。“能本地运行”不等于 CPU 实时、中文可靠或可以直接商用。

资料范围与限制

这份清单来自单车酒吧搞机社第 76 集《Vibe知识大赏|别光追大模型,这12个专精小模型也许更有用》,页面显示发布时间为 2026-10-19,时长 7 分 45 秒。整理时读到视频标题、作者、章节和平台摘要,并回看了约 02:19 的“决策模型”画面及约 02:48 的 Kev、0.8B→4B 画面;没有完整核听,也没有逐字稿。下面的六类清单来自视频转述,再逐项核对官方仓库、模型卡、许可和关键许可讨论。

资料核对集中在 2026-10-21 至 2026-10-24。没有安装或下载模型权重,没有调用模型、跑基准,也没有更改任何现有检索索引。这里记录的是候选和采用边界,不是最新最优模型排名,也不构成本机性能结论。

原转述称这些模型大多支持本地部署、不少 CPU 可运行,并提醒商用前核对授权。本文保留为转述,不将其扩大成统一的硬件或许可承诺。

名称辨析:Kev 与 Jev

视频约 02:48 的画面写着 Kev、0.8B→4B。Kev 是独立的 Jev-like 决策模型项目,提供兼容 TypeSafe System One API 的接口及自行训练/运行的权重;本次核对的家族包括 0.8B、4B、9B 和 27B。它们支持加速器与 CPU 回退,官方也提供 Apple Silicon MLX 路线,但不能把所有尺寸笼统称为轻量 CPU 模型。Kev-0.8B 权重及底座标注 Apache-2.0;中文表现和实际规则判断仍需自测。原转述中的“K5”没有独立证据,不作为已确认型号或 Jev 的别名。

Jev 则是 TypeSafe 的 System One 模型:读取 state 与类型化问题,返回 Choice(选项)、Score(评分)或 Noul(是/否概率),由应用代码决定后续分支和动作。它不是完整的 agent runtime,也不负责文本生成、工具执行或任务编排。

在核对资料时,官方模型页给出托管 API;未找到可核验的公开权重或自托管安装路线,因此不能把 Jev 计为“已确认可本地 CPU 部署”。当时官方最新发布为 jev-1.14.0,但 jev-latest 仍指向 jev-1.13.0、jev-preview 指向 1.14;对照测试应固定版本。官方说明英语效果最好,中文需要实测,概率校准也不保证单次判断正确。官方列出的 1.13 已知问题包括算术、日期比较、多跳判断、对抗输入及选项顺序敏感;这些不能直接当成 1.14 的实测结论。

12 个候选

类别/对象 适用任务与边界 部署与许可要点
决策:Laya 对输入和候选选项做分类、分级或二元判断并输出概率;多语言任务应选对应检查点。 官方支持 CPU/MPS/CUDA 等;多语言版约 322M、英文版约 421M。多语言权重标注 Apache-2.0。模型卡提示默认未校准、可能过度自信,部分零样本任务较弱。
决策:Kev 基于 Qwen 底座加决策适配/读出,返回选项概率;提供兼容 Jev 的 TypeSafe System One API,但两者是独立项目。 本次核对的家族含 0.8B/4B/9B/27B,支持加速器与 CPU 回退,也有 Apple Silicon MLX 路线。Kev-0.8B 权重及底座标注 Apache-2.0;中文和领域判断须自测。
分类:SetFit 少样本文本分类训练框架;需选择句向量底座、标签和训练数据,不是一个开箱即用的统一分类模型。 小底座、低吞吐任务可从 CPU 试起;中文应选择合适的多语言/中文底座。框架为 Apache-2.0,底座、数据及产出模型许可需分别核对。
抽取:GLiNER 按给定标签抽取人名、地点、组织等实体,可作为抽取或脱敏候选;不保证理解复杂关系、否定或整份业务文档。 官方强调 CPU/消费级硬件,并支持量化与 ONNX;中文需选多语言版本验证。已核实的 gliner_multi-v2.1 标注 Apache-2.0;早期部分权重为 CC-BY-NC,不能只看代码仓库许可。
语言识别:OpenLID 基于 fastText 的语言识别,覆盖 201 种语言;不是实体或字段抽取模型。 适合轻量 CPU 文本预处理;短文本、中英混写和领域词仍需验证。模型卡标注 GPL-3.0;这不等于禁止商用,但集成或分发时仍需核对适用义务。
向量:BGE-small 将文本编码成检索向量;中文场景可明确评估 bge-small-zh-v1.5,不要只写含糊的 small。 可作为 CPU 检索候选;切块长度、索引规模和批量吞吐都要测。该权重标注 MIT。更换 embedding 通常需要重编码相应索引,不宜只为尝鲜就重建现有检索。
重排:Jina Reranker v2 对 query/候选文档对评分,用于召回后的排序;不能替代 embedding 向量模型。 官方提供 CPU 路径;逐候选计算,延迟随候选数和文本长度上升。多语言 v2 权重标注 CC-BY-NC-4.0,商业使用需另有授权或采用相应商业服务。
转写:SenseVoiceSmall 语音识别及语种/情绪/事件标签。已发布 Small 的明确语种为普通话、粤语、英语、日语和韩语;多人说话人分离需要另配模型或流水线。 有 ONNX 等本地路线;桌面 CPU 转写不能证明嵌入式端低延迟或低功耗。源码 MIT;官方权重卡指向 FunASR 自定义模型许可,商业解释仍有待确认,见下文。
合成:F5-TTS 文本转语音/参考声音条件合成,与转写方向相反。 可本地推理,但 CPU/MPS/GPU 的吞吐和实时率需实测。代码 MIT,官方预训练权重 CC-BY-NC-4.0;不能因代码许可宽松就默认权重可用于商业语音链路。
超分:Real-ESRGAN 图像放大与修复,可用于素材处理;生成的细节不能当成原图事实。 适合离线批处理;ncnn/Vulkan 路线依赖相应图形能力,不等于纯 CPU 加速。仓库 BSD-3-Clause;权重、附带组件和输入素材权利需分别核对。
修补:LaMa 按掩膜补全图像区域,区别于语言模型 LLaMA。 官方有 CPU 推理示例,但大图速度和内存仍需测。仓库 Apache-2.0;权重与素材也需分别核对,生成区域不应被当作实物证据。
预测:Chronos-Bolt 从历史时间序列预测未来值/分位数;不是通用因果推断或自动调度器。 官方支持 CPU/GPU;Tiny 9M、Mini 21M、Small 48M、Base 205M。该权重标注 Apache-2.0。应按时间回测并与季节性朴素预测等基线比较;后续已有 Chronos-2,但这不自动替换本清单的研究对象。

SenseVoice 的许可边界

官方权重卡指向 FunASR Model License:§2 授予使用、修改、分享等权利并要求署名/保留模型名,§3 则包含“仅作为参考和学习使用”的措辞。

README 链接了一条允许商用/私有微调的成员回复,但该回复顶部已有 2026-09-22 状态更新,说明早期回复不是许可方最终确认。重新打开说明也称仍在等待许可方/核心维护者确认;本次核对时 issue #334仍为 open。

因此,较准确的记录是:商业许可解释待确认,不标作“已禁止商用”,也不标作“已完全澄清”。 正式商业集成前,应结合所选权重版本、协议和许可方最终确认;第三方 GGUF/ONNX 转换物也要另行核对。

Jev:适合筛选,不替人做决定

2026-10-24 阅读的公众号文章认为,Jev 更适合把大量输入做成筛选、分类、排序和检查结果,而非替人承担“要不要写、要不要发”这类需要背景、经验和责任的最终决定。文章提出的工作流是:生成模型起草候选,Jev 过滤或检查,人决定是否采用。

文章及其引用的社区案例报告了多种速度和成本数字,例如语音浏览器约 300ms、单次约 0.0002 美元;724 条广告约 40 秒、约 0.09 美元;3,282 条历史帖子约 8 分 34 秒、约 0.13 美元。另有航班搜索约 7.1 秒、Uber 演示约 21 秒但停在付款选择页。这些是作者/社区报告,不是独立复现或统一基准:模型版本、并发、重试、网络和计费边界并不齐全,不能外推为通用性能承诺。

接入形式也要以官方资料为准:官方介绍说明 Jev 直接返回类型化结果,而不是生成文本;快速入门使用 typesafe-sdk/TypeSafeClient 的 system_one 调用,以 state 加 Choice、Score 或 Noul 提问。原文章中出现的 OpenAI(base_url=...) + chat.completions + 自定义 JSON 输出,与本次读取的官方接入方式不一致,不能直接当作官方可运行示例。本次没有运行这些代码或调用 API。

原文章小标题称“12 个案例”,正文实际编号到 10;聊天案例还同时出现“约 1 秒”和“70 毫秒”两种判断耗时,测量口径不清。Uber 演示没有完成叫车,仿真也不能代表真实控制;快速判断更不能代替原始来源核验或证明事实正确。

怎样开始评估

  1. 资料结构化:先测抽取,再决定是否加分类。 用有代表性的样本副本提取日期、型号、组织和待确认事项,保留原文位置;复杂否定、责任和历史修正交由人或更强的模型复核。固定格式和编号优先考虑规则;只有分类量和标签样本确实存在时,再评估 SetFit。留出测试集,按字段报告精确率和召回率。
  2. 离线语音转写:先量化人工修订负担。 多人分离、标点和领域词汇可能还需额外处理。开放环境还要单独验证拾音、风噪和回声;桌面 CPU 转写不能证明嵌入式设备可实时、低功耗运行。F5-TTS 默认权重不应在商业许可未收敛前直接纳入商业语音链路。
  3. 检索:先评估现有结果,再决定是否换模型。 若中文召回确有不足,用小规模副本和固定问答集比较 BGE-small-zh;重排则单独衡量排序增益与额外延迟。更换 embedding 前应确认重编码成本;Jina v2 的商业授权也需先解决。
  4. 图像工具按需使用,预测放后。 Real-ESRGAN/LaMa 可用于有权处理的资料图片或演示素材,不必常驻服务。等积累足够时间序列后,再将 Chronos-Bolt 与简单预测基线比较;预训练模型不能补出不存在的运营数据。

若把决策模型用于工单或任务路由,应先与规则/标签基线比较,保留低把握和异常输入的人工复核;在真实领域数据上验证、校准后,再讨论概率阈值。把一个大问题拆成单一、可评估的 Choice/Score/Noul 判断,规则负责确定性判断,复杂任务交给生成模型或人工处理。

支付、权限变更、发布以及其他不可逆或安全关键动作,模型只能提供候选或风险信号,不能替代确定性授权和人的最终确认。模型组件可以串接在脚本或工具流程中;能组合不代表必须部署一个总控平台,现有工具接口足够时直接复用即可。

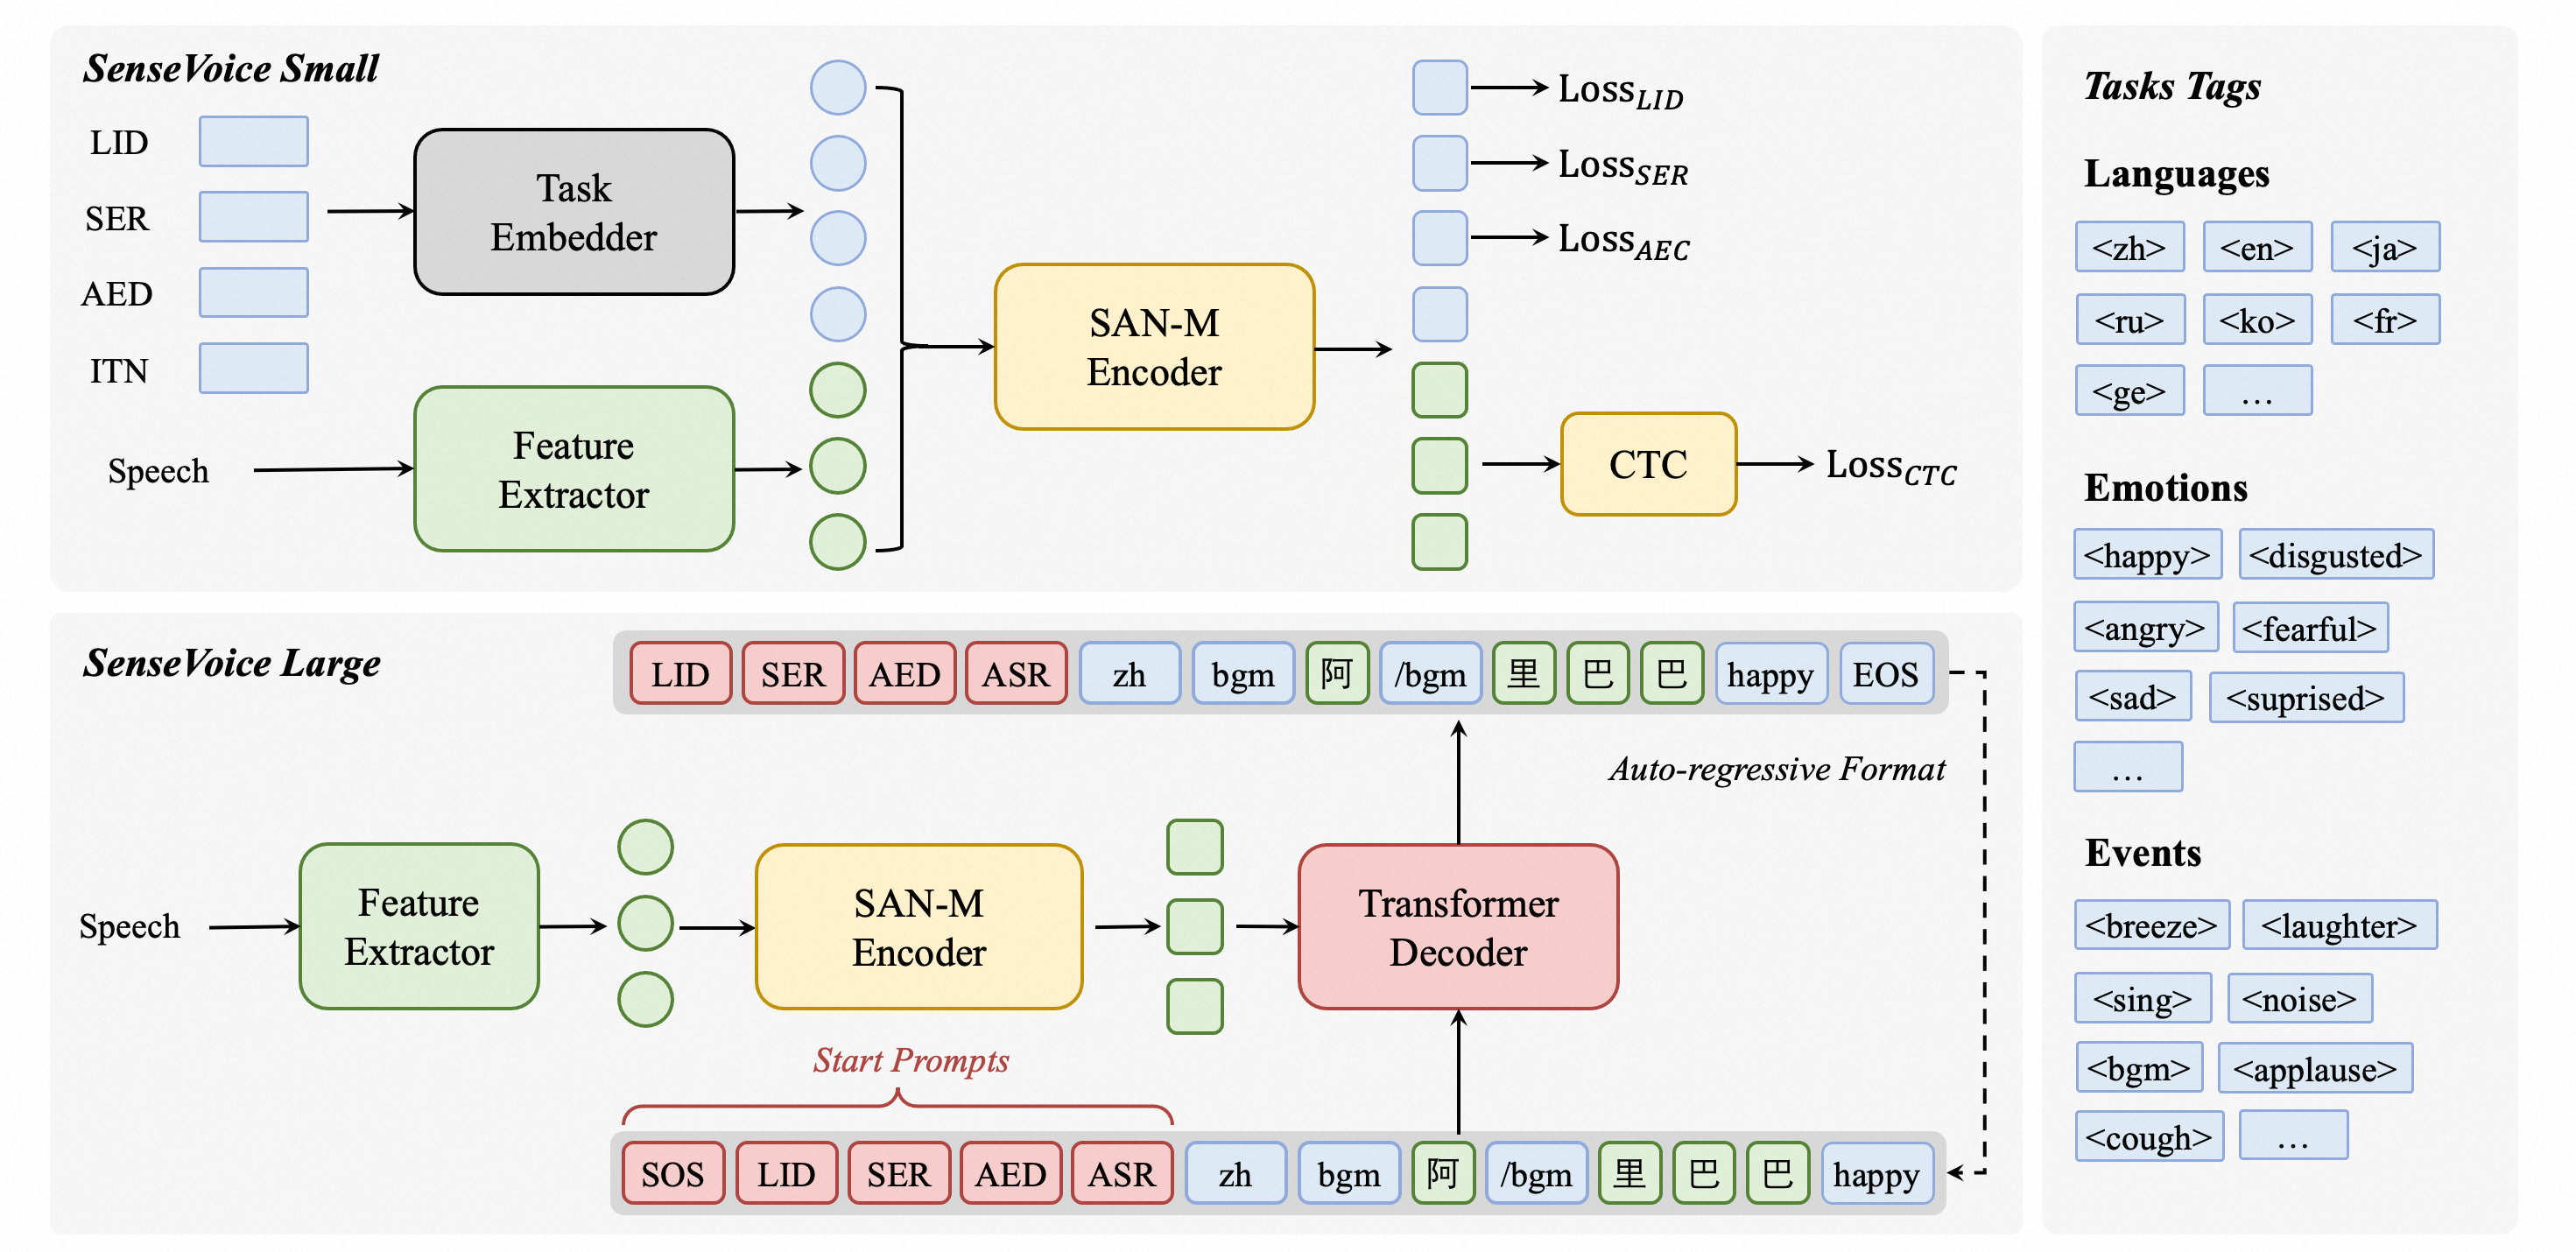
SenseVoice 架构示意

SenseVoice 官方架构示意。图中展示 Small/Large 和家族标签;不能把全部语言标签都视为已发布 Small 的能力列表。

图片来源:FunAudioLLM/SenseVoice。该图用于说明专用语音组件,不代表整份模型清单。